 CloudConsole
AWS Cost Anomaly Detection の仕組み
AWS Cost Anomaly Detection は、Cost Explorer のデータに機械学習を使い、いつものパターンから外れた支出を検出して、根本原因をサービス、アカウント、リージョン、使用タイプで報告します。実行は 1 日に約 3 回なので、異常が表示されるまで最大 24 時間かかることがあります。モニター(何を監視するか)とアラートのサブスクリプション(誰に、どの頻度で、どの影響額以上で通知するか)を選びます。
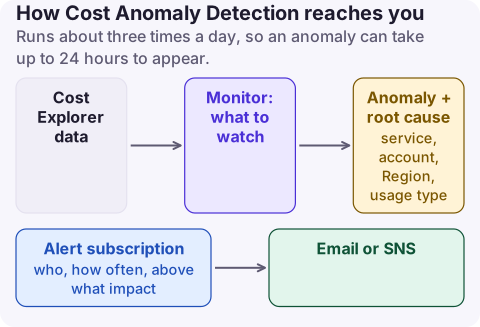
仕組み
- モニター:AWS マネージドモニターは、すべてのサービス、リンクされたアカウント、コストカテゴリ、タグの値をそれぞれ独立して追跡します。カスタマーマネージドモニターは、選んだ特定の範囲を監視します。
- データ:Cost Explorer の純粋な非ブレンドコストで、最大 24 時間遅れます。新しいモニターが動き始めるまで 24 時間かかることがあり、新しく使い始めたサービスは、異常を検出できるまで約 10 日分の履歴が必要です。
- アラート:SNS による個別のアラート(チャットアプリケーションの Amazon Q Developer 経由で Slack や Chime に送れます)、または日次と週次のメールの要約です。
- しきい値:絶対値(ドルでの影響額)または割合(予想支出に対する影響)で、2 つを AND または OR で組み合わせられます。
- カバーされない範囲:AWS Marketplace の料金は監視されません(Amazon Bedrock のサードパーティのモデルを除く)。それには予算を使いましょう。
CLI で設定する
# A monitor that tracks each AWS service separately
aws ce create-anomaly-monitor --region us-east-1 \
  --anomaly-monitor '{"MonitorName":"per-service","MonitorType":"DIMENSIONAL","MonitorDimension":"SERVICE"}'

# Immediate alerts to SNS when an anomaly's impact is at least $50
aws ce create-anomaly-subscription --region us-east-1 \
  --anomaly-subscription '{
    "SubscriptionName":"anomalies-to-oncall",
    "MonitorArnList":["arn:aws:ce::123456789012:anomalymonitor/abcd1234-ab12-cd34-ef56-abcdef123456"],
    "Subscribers":[{"Type":"SNS","Address":"arn:aws:sns:us-east-1:123456789012:cost-anomalies"}],
    "Frequency":"IMMEDIATE",
    "ThresholdExpression":{"Dimensions":{"Key":"ANOMALY_TOTAL_IMPACT_ABSOLUTE","Values":["50"],"MatchOptions":["GREATER_THAN_OR_EQUAL"]}}}'
SNS トピックには、costalerts.amazonaws.com の発行を許可するポリシーが必要です。メールのサブスクライバーは、日次または週次の頻度でしか使えません。
異常を読み解く
aws ce get-anomalies --region us-east-1 \
  --date-interval StartDate=2026-11-01,EndDate=2026-11-17 \
  --query 'Anomalies[].[AnomalyStartDate,Impact.TotalImpact,RootCauses[0].Service,RootCauses[0].Region,RootCauses[0].UsageType]' \
--output table最も役に立つのは根本原因の使用タイプです。EUW2-NatGateway-Bytes なら NAT のバイトのページ (EN)へ、DataProcessing-Bytes ならログの取り込みへ進みます。各異常にフィードバック(正確、計画済みのアクティビティ、異常ではない)を返しましょう。今後の検出の改善に使われます。
効果的に使う
- 自分にとって意味のある絶対値のしきい値(小さなアカウントなら $20、大きなアカウントなら数百ドル)から始め、数週間ノイズを見てから調整します。
- 月ごとの予算と組み合わせましょう。異常検出は急な変化を、予算はゆっくりした増加を捕まえます。
- 1 日の遅れは想定しておきましょう。漏えいしたアクセスキーで GPU インスタンスが起動されるような場合は、CloudTrail と GuardDuty の検出結果のほうが速いシグナルです。
やってはいけないこと:計画どおりのリリースを深く考えずに「異常ではない」とすること。「計画済みのアクティビティ」を使えば、モデルがその違いを学習します。
組織では、自分たちの支出を管理するチームごとに、リンクされたアカウントやコスト配分タグ単位のモニターを作り、誰も読まない共有の受信箱ではなく、チームごとにサブスクリプションを送りましょう。
よくある質問
AWS Cost Anomaly Detection は無料ですか?
AWS は Cost Anomaly Detection 自体の料金を掲載していません。支払うのは、アラートを届ける SNS などのサービスの分だけです。
Cost Anomaly Detection はどれくらい速くアラートを出しますか?
最大 24 時間遅れる Cost Explorer のデータで 1 日に約 3 回実行されるため、支出からアラートまで最大 1 日かかると考えましょう。
Cost Anomaly Detection は Slack に通知できますか?
はい。チャットアプリケーションの Amazon Q Developer(旧 AWS Chatbot)に接続した SNS トピック経由で通知できます。
異常のアラートは、その背後の内訳をすぐに確認できてこそ役に立ちます。AWS 用のスマホアプリ CloudConsole は、使用タイプごとの説明付きでサービスと使用タイプ別の支出を表示します。異常のメールにはない、その文脈です。
アプリについて → · App Storeからダウンロード